Agent 时代,结构化数据查询到底怎么做?
项目刚立项一周,数据团队就被一个简单需求难住了 —— 给“销售预测Agent”接数据。
销售预测看着只是查销量,其实需要三方数据对齐:
销售域的订单和线索、财务域的历史实收(收入口径需与财务对账一致)、生产域的产能和交期(预测销量需结合产能确认交付可行性)。
打开查询接口清单可见:销售域3套系统共20个接口、财务15个、生产 30多个,且均为纯数据查询接口,每个接口都需单独定义参数、配置鉴权、规范返回格式。团队负责人初步测算,仅数据接入工作就需要十余天。
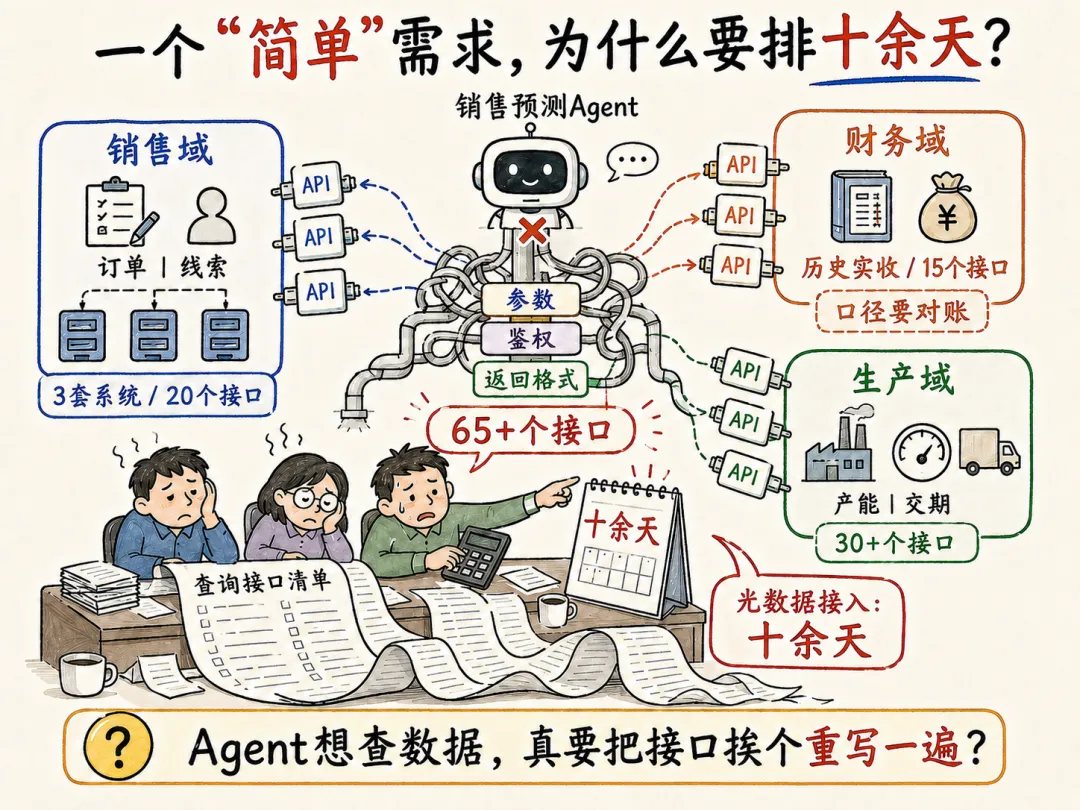
这是近期与一位制造企业数字化负责人交流时的真实场景,他最终提出了行业共性疑问:“Agent 想查数据,难道真要把这些查询接口挨个重写一遍?”
这个问题,也是 Agent 时代所有企业必须直面的核心问题:结构化数据查询,到底该走哪条路?
先说第一条路:逐个按需开发数据查询 API。
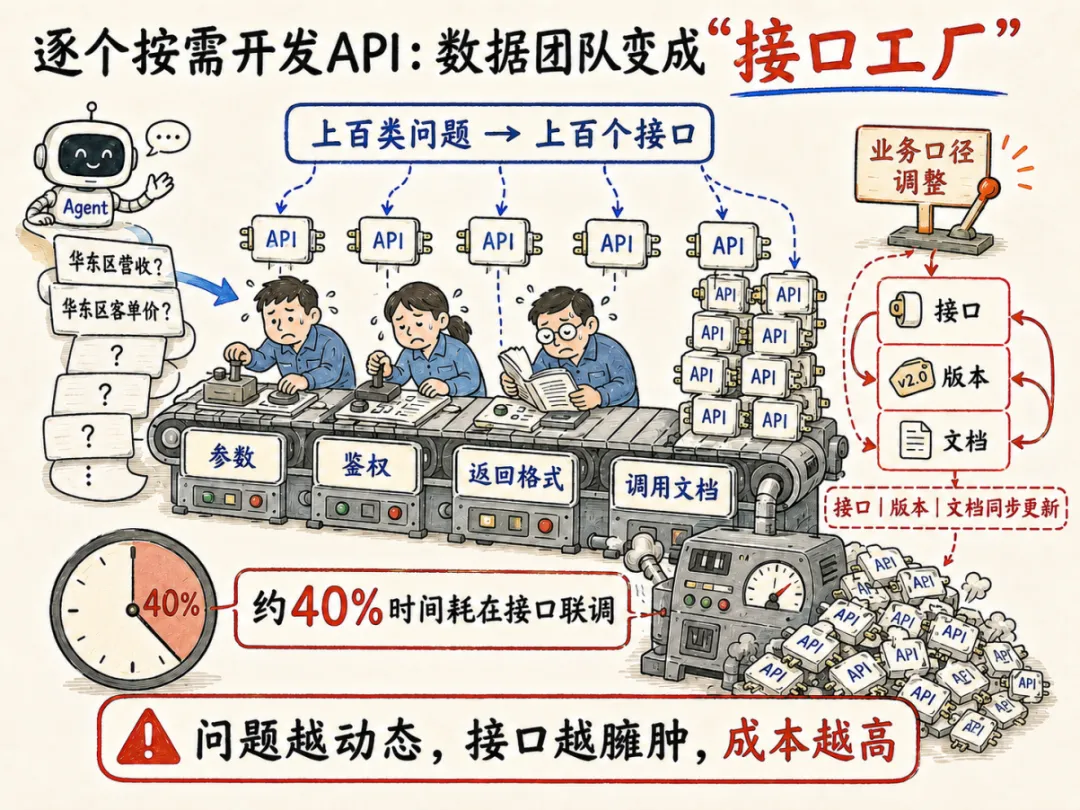
Agent需要解答上百类数据问题,就需要维护上百个查询接口,全程重复定义参数、处理鉴权、统一返回格式、编写调用文档。一旦业务口径调整,接口、版本、文档都需同步迭代更新。
开发团队常年约 40% 的工作时间消耗在接口联调上,数据团队逐渐沦为 “接口工厂”。
更关键的是,Agent 业务场景具备极强的动态性:业务今日询问 “华东区营收”,明日询问 “华东区客单价”,全新的提问方式往往需要新增专属接口。这条路,越迭代越臃肿、成本越来越高。
再说第二条路:让大模型直接生成 SQL。
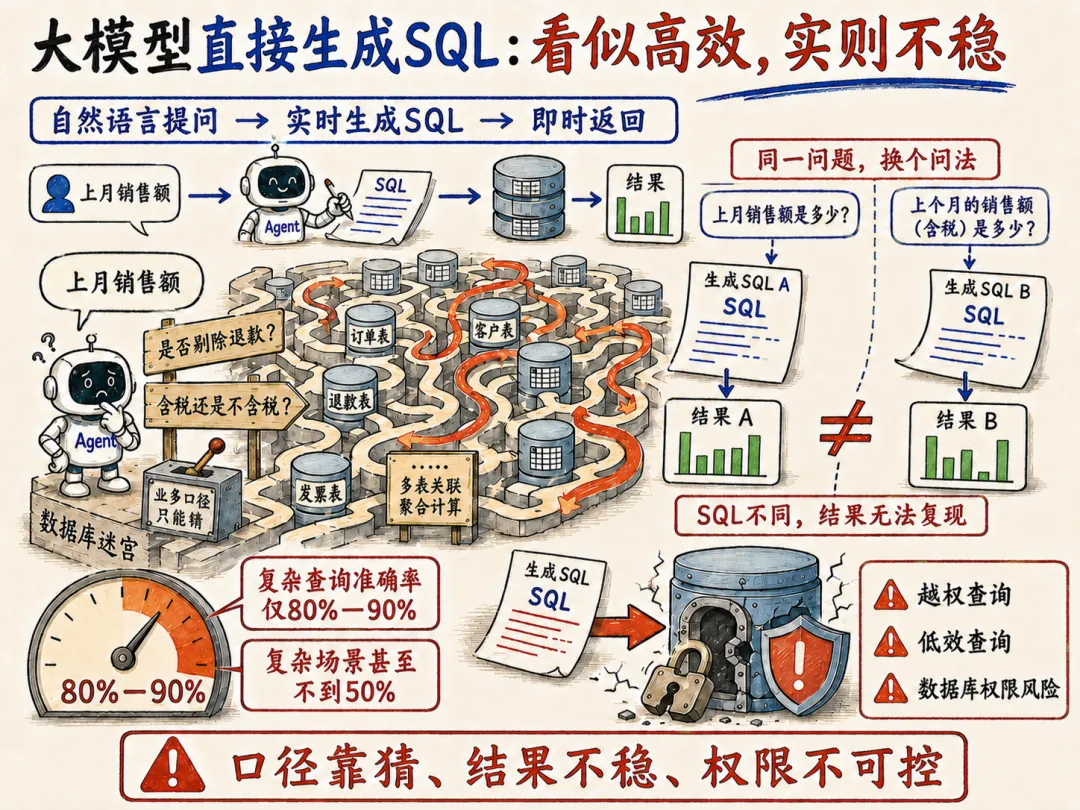
自然语言提问、模型实时生成 SQL、即时查询返回结果,这套模式看似高效完美。
但落地企业真实场景后弊端尽显:企业数仓拥有海量字段,字段命名不规范、历史脏数据多,大模型无法精准识别真实业务语义。“上月销售额” 是否剔除退款、是否为含税口径等核心规则,模型只能主观猜测。
行业公开评测数据显示,面对多表关联、复杂聚合的真实业务问题,Text2SQL 的有效准确率仅维持在 80%-90%,复杂场景准确率甚至不到50%。同时,同一问题更换提问方式,生成的 SQL 语句完全不同,查询结果无法复现,无法支撑企业决策落地。
除此之外还存在极大安全风险:让模型直接生成并执行 SQL,等同于开放数据库权限,极易出现越权查询、低效查询等风险,后果不可控。
第三条路:指标平台,结构化数据查询的统一入口。
按需开发API的痛点,是将轻量化的数据查询,复杂化转为定制开发工作;直接使用Text2SQL的弊端,是将严谨的业务口径,交由大模型临场随机生成。两种方案的核心症结一致:每一次数据查询,都需要从零开始构建逻辑。
指标平台的落地思路彻底颠覆传统模式:Agent 查询数据,本质是查询标准化业务指标,而非原始数据库表数据。用户询问 “华东区上月营收”,需要的不是一段临时 SQL,而是口径统一、逻辑确定、可溯源的标准答案。
指标平台提前沉淀所有业务指标的计算口径、统计逻辑、维度权限,形成标准化指标库。用户发起查询时,由大模型负责理解用户语义、匹配对应指标,由指标平台完成标准化、确定性的数据查询执行。
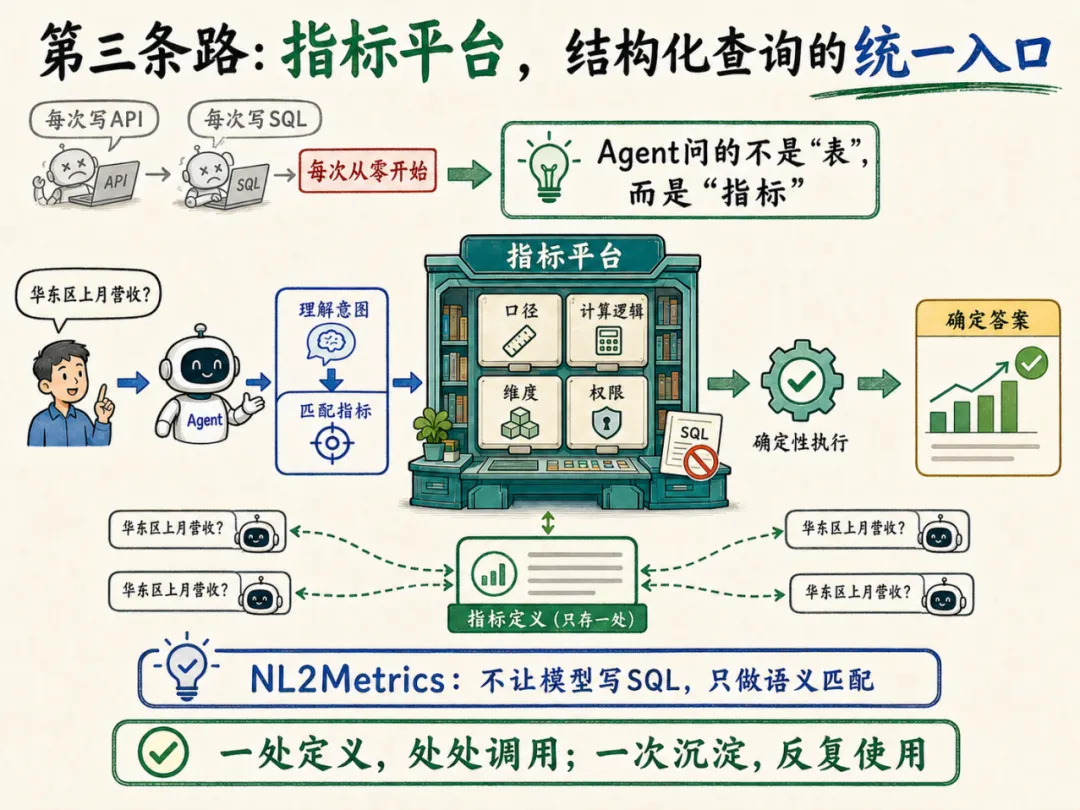
这就是行业主流的 NL2Metrics 落地思路:不让大模型自由生成逻辑代码,只发挥其语义理解、意图匹配的核心能力,扬长避短,规避模型逻辑不稳定的短板。
简单来说,指标平台是企业结构化数据查询的统一入口,实现一次口径定义、全场景复用,一次指标沉淀、Agent 反复调用。
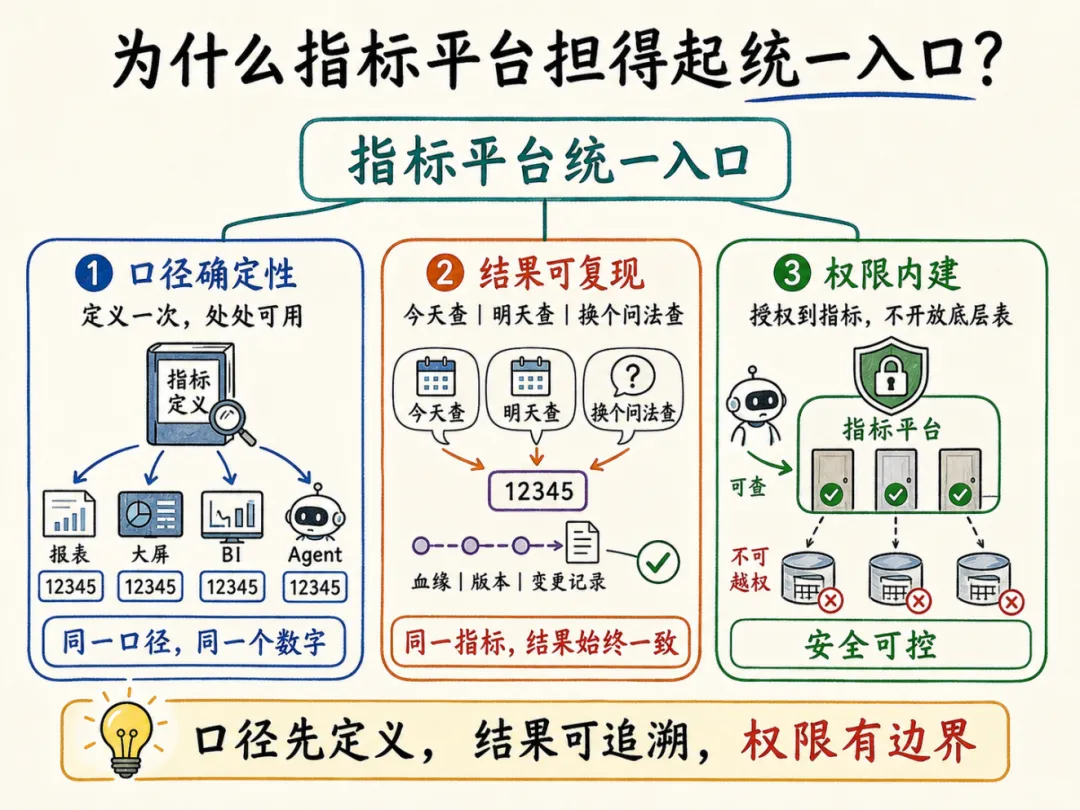
基于此,企业可以明确各类数据工作的边界分工: 数据增删改、业务流程执行等写操作场景,依旧沿用传统 API 方案,这是 API 的核心适用场景;复杂深度的数据建模、底层数据挖掘工作,交由数据工程师手写 SQL 实现;而企业绝大多数常规结构化数据查询需求,均可统一通过指标平台完成。
Agent 落地的核心,并非单纯依赖大模型自动化,而是将碎片化、不确定的业务数据逻辑提前标准化、确定性沉淀。这也是企业Agent 能够稳定落地、安全可用、真正赋能业务的关键。